95 - Lühiülevaade: LLM, agendid, ai-proxy, Pi ja spec-driven arendus
Siit saad põhimõisted, tasuta ligipääsu Qwen3.8 27b mudelile kooli ai-proxy kaudu ja Pi coding agenti 5-minuti seadistuse.
| Kui sul on... | Loe |
|---|---|
| 5 minutit | §5 ai-proxy ja §6 Pi + Qwen3.8 |
| 15 minutit | kõik allpool |
| rohkem | lingid iga osa lõpus viivad täisloengutesse |
1. LLM — järgmise tokeni ennustaja
LLM (Large Language Model) pole maagia. See on närvivõrk, mis on treenitud ühte ülesannet täitma: ennusta järgmist tokenit. Kõik muu — chat, koodi genereerimine, agendid — on kihid selle peal.
Kui annad sisendiks "Pealinn Eestis on", tagastab mudel tõenäosusjaotuse järgmise tokeni üle: Tallinn 94%, Helsinki 2%, Riia 1%, jne. Valib ühe, lisab sisendisse, kordab. Ring käib, kuni kontekst saab täis või mudel ennustab spetsiaalse <END> tokeni.
Põhitõed:
- API on stateless. Mudel ei mäleta eelmisest päringust mitte midagi. Iga sõnum API-le sisaldab kogu eelnevat vestlust uuesti. "Mälu" on kliendi (harness'i) probleem, mitte mudeli oma.
- Mudel ei "mõtle" — ta genereerib tokeneid. "Reasoning" mudelid genereerivad lihtsalt rohkem tokeneid enne vastust.
- Halb vastus = halb kontekst. Enne kui süüdistad mudelit, mõtle: mis oli täpselt sellel hetkel sisendis?
Süvitsi: Loeng 01 — Intro, Loeng 11 — AI basics.
2. Token ja kontekstiaken
Token pole sõna ega täht — see on midagi vahepealset (subword, tavaliselt BPE-tokenizer). "tokenization" = 2 tokenit, "getElementById" = 4 tokenit (get, Element, By, Id). Umbes 4 tähemärki inglise keeles = 1 token. Eesti keel on kallim — ~1.5× rohkem tokeneid sama info kohta, sest tokenizer on treenitud peamiselt inglise keele peal.
| Mõiste | Mis see on | Miks see loeb |
|---|---|---|
| Kontekstiaken | Max sisend + väljund tokenites | 200k/1M Claude, 256k Qwen3.8, 8k vana GPT-3.5 |
| Input price | $ per miljon sisendtokenit (MTok) | Maksad iga kord, kui saadad terve vestluse uuesti |
| Output price | $ per miljon väljundtokenit | Tavaliselt 3–5× kallim kui input |
Mida see praktikas tähendab:
- Kontekstiaken peab mahutama nii sisendi kui väljundi. Süsteemiprompt + tööriistade kirjeldused +
AGENTS.mdvõtavad agendi puhul juba ~20% enne, kui sa midagi küsid. - Kvaliteet hakkab langema ~75% täituvusel. Seepärast on harness'ides
/compact— vana vestlus võetakse kokku. - Prompt cache: kui vestluse algus ei muutu, on korduv sisend ~90% odavam. Harness'id kasutavad seda ise.
Süvitsi: Loeng 02 — Token, Loeng 29 — kontekstihaldus.
3. Tools — tool calling
Mudel ei saa ise faili lugeda, internetist otsida ega shell-käsku käivitada. Aga ta saab paluda, et keegi teine seda teeks.
Tool calling on leping. Sa ütled mudelile "sul on olemas järgnevad tööriistad" koos JSON-schema'ga. Mudel, kui vajab, genereerib väljundiks struktureeritud JSON-i: {"tool": "read_file", "path": "/etc/hosts"}. Mudel ise ei käivita midagi — ta toodab teksti, mis ütleb "ma tahan kutsuda tööriista X argumentidega Y". Sinu kood (harness) näeb seda, käivitab tööriista ja saadab tulemuse mudelile järgmises päringus tagasi.
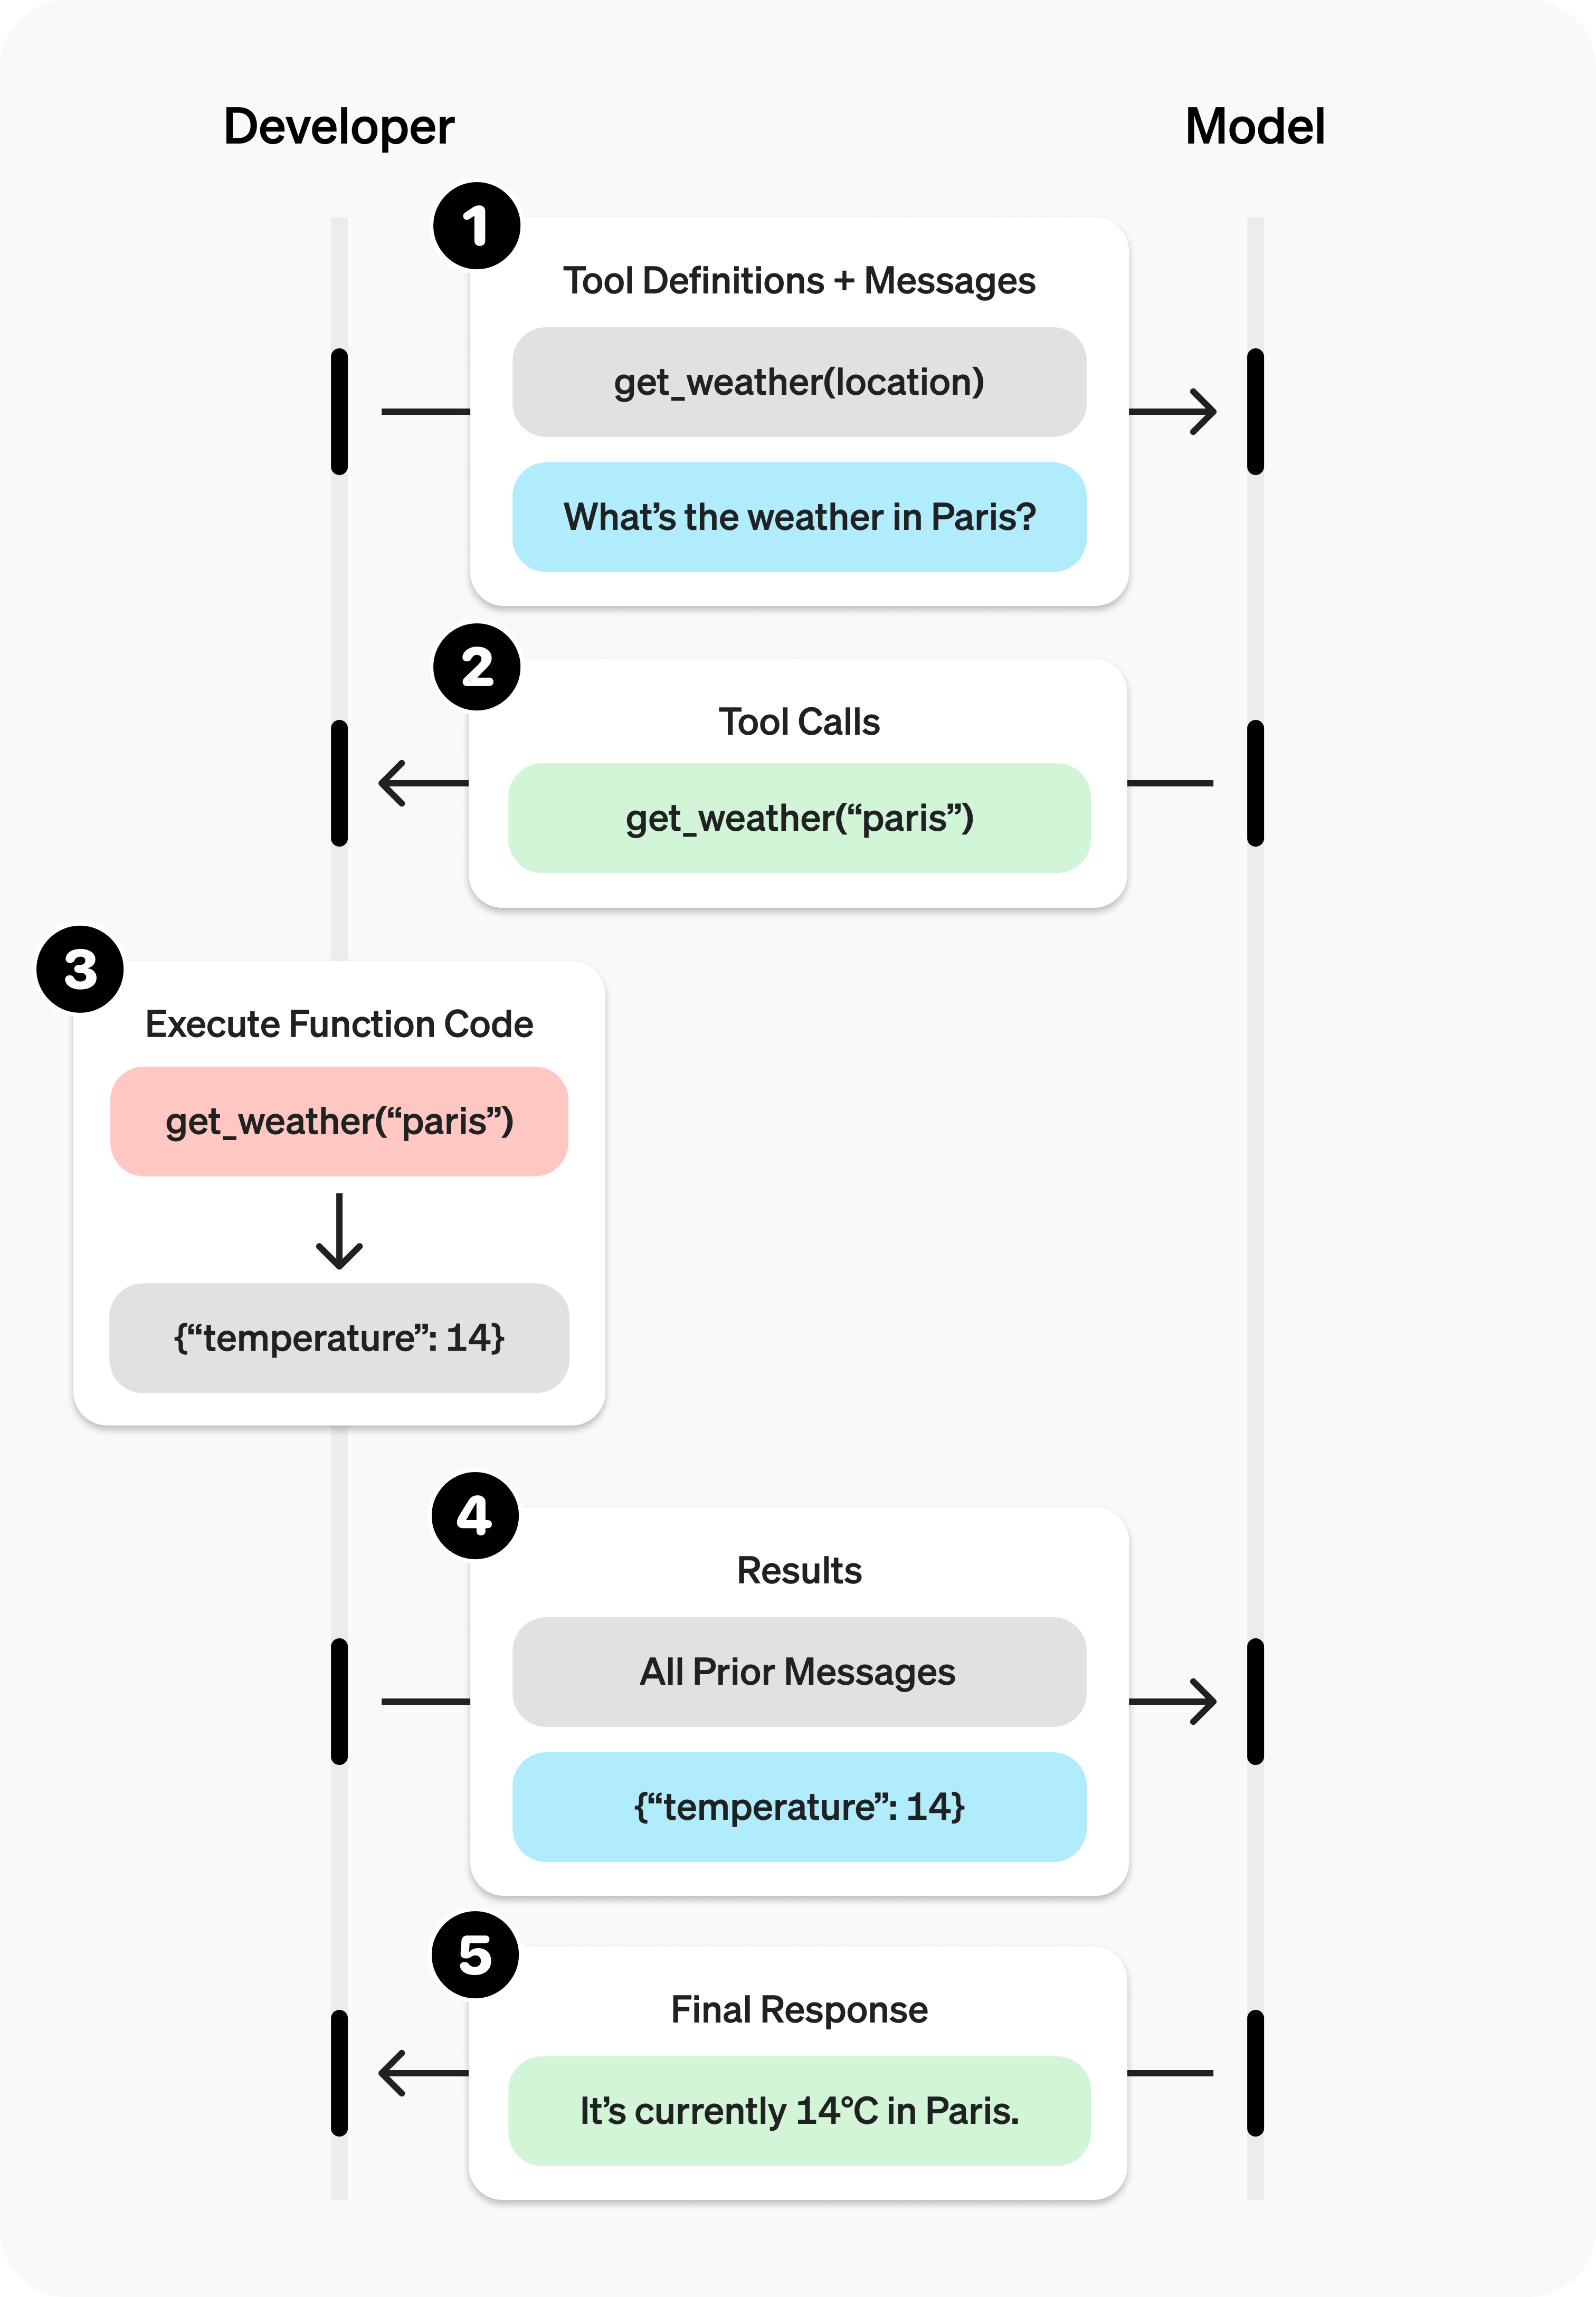
Tööriist on mudeli jaoks kolm asja:
| Osa | Mis | Märkus |
|---|---|---|
| Nimi | read_file | Lühike, ühemõtteline |
| Kirjeldus | "Loeb faili sisu antud teelt. Kasuta enne muutmist." | Tähtsaim osa — halb kirjeldus = tööriista ei kutsuta kunagi |
| Input schema | JSON Schema parameetritele | Mudel täidab selle |
Iga tööriista kirjeldus maksab tokeneid igas päringus: 30 tööriista ≈ 6000 tokenit enne, kui sa üldse midagi küsid. Vähem ja paremini kirjeldatud tööriistu on parem kui palju.
Süvitsi: Loeng 26 — Tools, Loeng 27 — MCP.
4. Harness — agent = LLM + tsükkel + tööriistad
Pane tool calling stateless API-sse ja saad tsükli:
while not done:
    response = llm.call(messages, tools)
    if response.wants_tool_call:
        result = execute_tool(response.tool_call)
        messages.append(response)
        messages.append(tool_result(result))
    else:
        done = True
        return response.text
See silmus ongi agent. Planeerimine, refleksioon, veaparandus — kõik see tekib prompt'idest, tööriista-disainist ja orkestratsioonist, mitte mudelist.
Agendi harness on CLI- või IDE-tööriist, mis mässib LLM-i sellesse silmusesse: loeb sinu promptid, saadab mudelile, võtab tagasi tool-call'id, käivitab need, saadab tulemuse mudelile, kordab kuni töö tehtud. Erinevus pole mudel — erinevus on infra silmuse ümber: millised tööriistad on sisseehitatud, kuidas konteksti hallatakse, kuidas õigusi kontrollitakse, milline on konfiguratsioon.
| Harness | Kust pärit | Mudelid | Eripära |
|---|---|---|---|
| Pi | avatud lähtekood | Kõik (openai-compatible, anthropic, ...) | Minimalistlik: 4 tööriista (read, write, edit, bash), kõik muu ehitad/paigaldad ise. Meie vaikevalik kooli proxyga. |
| Claude Code | Anthropic | Claude perekond | Kõige küpsem: skills, hooks, subagents, plan mode |
| opencode | SST (avatud lähtekood) | Kõik | Multi-provider, granulaarsed õigused, AGENTS.md |
| OpenAI Codex | OpenAI | GPT perekond | Terminal + VS Code; AGENTS.md standard |
| Kilo Code | avatud lähtekood | Kõik | VS Code laiendus, mode'id (architect/code/ask) |
| Cursor | Anysphere | Kõik | VS Code fork — aga lock-in |
Kõigil on sama alusmuster: projekti instruktsioonid (AGENTS.md / CLAUDE.md), tööriistad + MCP, skills, hooks, kontekstihaldus. Tööriist on vahetatav, reeglid tekstifailides on püsivad.
Süvitsi: Loeng 30 — Agents, Loeng 21 — AI tooling, 94 — BitWeb.
5. ai-proxy.cm.itcollege.ee — kooli LLM ligipääs
Kool pakub tudengitele piiratud LLM API ligipääsu. Proxy asub aadressil https://ai-proxy.cm.itcollege.ee/ ja:
- autendib tudengi tema isikliku API-võtmega,
- vahetab päringus tudengi võtme kooli võtme vastu ja saadab päringu edasi (Azure, Central Sweden — EL, GDPR),
- loeb kasutust ja kulu, kontrollib krediiti,
- proksib päringud sisuliselt muutmata (ka streaming/SSE töötab),
- juurdepääs ainult eesti IP aadressidelt (kasuta vpni vajadusel)
- vajab uni-id sisselogimiseks
Kuidas ligipääsu saada:
- Mine https://ai-proxy.cm.itcollege.ee/ ja logi sisse (uni-id).
- Loo endale isiklik API-võti.
- Salvesta see keskkonnamuutujasse (vt §6, samm 3).
API-võti on isiklik. Ära pane seda git'i, avalikku dokumenti ega jaga teistega. Kõik, mida selle võtmega tehakse, läheb sinu arvele.
Endpointid ja mudelid:
Base URL (https://ai-proxy.cm.itcollege.ee + ...) | API kuju | Mudel(id) | Hind |
|---|---|---|---|
/hpcvllm/v1 | OpenAI chat completions | Qwen3.8-27B | TASUTA (TalTech HPC, RTX6000) |
/vllm/v1 | OpenAI chat completions | cyankiwi/Qwen3.6-27B-AWQ-BF16-INT4 | TASUTA (akaveri isiklik server, 2× RTX 4090) |
/azure-openai | OpenAI responses | gpt-5.4, gpt-5.3-codex, ... | krediidist |
/azure-models | OpenAI chat completions | grok-code-fast-1, Kimi-K2.5, DeepSeek-V3.2, codestral-latest | krediidist |
/azure-anthropic | Anthropic messages | claude-sonnet-4-6, claude-opus-4-6 | krediidist, küsi ligipääsu (kallis) |
- Autentimine: päis
Authorization: Bearer <sinu-võti>võix-api-key: <sinu-võti>. - Mudelinimed on tõstutundlikud. Azure'il pole
modelsendpointi, nimed tuleb käsitsi õigesti kirjutada. vLLM-idel onmodelsendpoint olemas:
curl -sS -H "Authorization: Bearer $TALTECH_API_KEY" https://ai-proxy.cm.itcollege.ee/hpcvllm/v1/models
curl -sS -H "Authorization: Bearer $TALTECH_API_KEY" https://ai-proxy.cm.itcollege.ee/vllm/v1/models
Alusta tasuta Qwen3.8-ga. Tasulisi mudeleid kasuta siis, kui tead, miks sul neid vaja on — krediit on piiratud.
Täisdokumentatsioon (Kilo Code, opencode ja curl näited iga mudeli kohta, kulunäited): Loeng 99 — ai-proxy.
6. Pi coding agent + Qwen3.8 — 5-minuti seadistus
Pi on minimalistlik terminali coding agent: neli tööriista (read, write, edit, bash), sessioonid, AGENTS.md tugi ja kõik muu (subagendid, plan mode, MCP) laiendustena. Töötab iga openai-compatible API-ga (ja ka Anthropicu apiga), seega ka kooli proxyga.
Samm 1 — Node.js. Pi vajab Node.js ≥ 22.19. Kui pole, paigalda nvm ja seejärel:
nvm install --lts
node --version
Samm 2 — Pi.
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
pi --version
Laiendused (https://pi.dev/packages):
pi install npm:pi-web-access
pi install npm:pi-subagents
pi install npm:@juicesharp/rpiv-ask-user-question
Hiljem uuendamiseks pi update ja pi update --extensions.
Samm 3 — API-võti keskkonnamuutujasse. Lisa oma ~/.zshrc või ~/.bashrc faili (Windowsis kasuta WSL-i):
export TALTECH_API_KEY='sinu-võti-ai-proxyst'
Ava uus terminal (või source ~/.zshrc).
Samm 4 — mudeli konfiguratsioon. Loo fail ~/.pi/agent/models.json:
mkdir -p ~/.pi/agent
chmod 700 ~/.pi/agent
{
  "providers": {
    "hpc-vllm": {
      "baseUrl": "https://ai-proxy.cm.itcollege.ee/hpcvllm/v1",
      "api": "openai-completions",
      "apiKey": "$TALTECH_API_KEY",
      "compat": {
        "supportsUsageInStreaming": true,
        "maxTokensField": "max_tokens",
        "supportsDeveloperRole": false
      },
      "models": [
        {
          "id": "Qwen3.8-27B",
          "reasoning": true,
          "contextWindow": 262144,
          "thinkingLevelMap": {
            "minimal": null,
            "low": "low",
            "medium": "medium",
            "high": null,
            "xhigh": "xhigh",
            "max": null
          },
          "compat": {
            "thinkingFormat": "chat-template",
            "chatTemplateKwargs": {
              "enable_thinking": { "$var": "thinking.enabled" },
              "reasoning_effort": { "$var": "thinking.effort", "omitWhenOff": true }
            }
          },
          "input": ["text", "image"]
        }
      ]
    }
  }
}
chmod 600 ~/.pi/agent/models.json
"apiKey": "$TALTECH_API_KEY" tähendab, et Pi loeb võtme keskkonnamuutujast — võti ise faili ei lähe.
Samm 5 — käivita.
pi --list-models Qwen3.8                 # peab näitama hpc-vllm/Qwen3.8
cd ~/minu-projekt
pi --model hpc-vllm/Qwen3.8-27B
Et mitte iga kord --model lippu kirjutada, pane vaikemudel faili ~/.pi/agent/settings.json:
{
  "defaultProvider": "hpc-vllm",
  "defaultModel": "Qwen3.8-27B",
  "defaultThinkingLevel": "medium"
}
Edaspidi piisab lihtsalt pi käsust projekti kaustas. Mudelit saab sessiooni sees vahetada /model käsuga või Ctrl+L.
| Käsk / klahv | Mida teeb |
|---|---|
/model või Ctrl+L | Vali mudel |
--thinking low|medium|xhigh | Mõtlemise tase (Qwen3.8 toetab neid kolme); Shift+Tab vahetab sessiooni sees |
/compact | Võta vestlus kokku, kui kontekst hakkab täis saama |
/new, /resume | Uus sessioon / jätka vana |
/settings | Vaikemudel, teema jm |
pi -p "küsimus" | Ühekordne vastus ilma TUI-ta |
/quit | Välju |
Rohkem mudeleid: tasuta Qwen3.6 ja tasulised GPT/Claude mudelid lisad samasse faili — täielik neljaproviderline
models.jsonon Loeng 99 — ai-proxy lehel.
Pikem samm-sammult juhend (nvm, Linux/WSL detailid): enos.itcollege.ee/~japoia/algoritmid/pi-agent.html.
7. Spec-driven arendus — põhiprintsiibid
Enamik arendajaid kirjutab kõigepealt koodi ja dokumenteerib pärast (kui üldse). Spec-driven arendus (SDD) pöörab selle ümber:
idee → spec → plaan → kood
Spec on tõe allikas. Kood on spec'ist tulenev artefakt, mille AI genereerib. Sinu roll pole ainult juhtida — see on verifitseerida: igas faasis kontrollid, kas spec ütleb seda, mida sa tegelikult tahad, kas plaan arvestab päris piirangutega, kas midagi jäi puudu. AI genereerib artefaktid, sina vastutad, et need on õiged. Eriti oluline mõtiskleda selle üle, et mis on puudu...
Spec on käitumisleping, mitte implementatsiooniplaan: sisend, väljund, veaolukorrad, välised piirangud. Spec ei nimeta klassinimesid ega teeke — need on design'i tasand. Kiire test: kui implementatsioon võib muutuda ilma, et väline käitumine muutuks, siis see ei kuulu spec'i.
| Tase | Mis | Millal |
|---|---|---|
| Spec-first | Kirjuta spec, genereeri kood, kustuta spec. Kood on allikas. | Ühekordne ülesanne, plan/architect mode |
| Spec-anchored | Spec jääb alles, uueneb koos koodiga. | Enamik päris-kasutust |
| Spec-as-source | Ainult spec'i redigeeritakse, kood regenereeritakse alati. | Aspiratsiooniline, täna ei tööta hästi |
Kõik SDD tööriistad (OpenSpec, Spec-Kit, BMAD, ...) teevad sama voogu; erinevus on selles, kus on inimese kontroll, kuidas spec'e versioonitakse ja kas on multi-agent orkestratsioon.
Spec-driven arendus ei tee AI-d paremaks. See teeb sind paremaks lepingute kirjutamisel. Ja lepingute kirjutamine on see, mis eraldab juuniori vanemarendajast.
Süvitsi: Loeng 22 — Spec-driven, Loeng 24 — Spec-Kit, Loeng 25 — BMAD.
8. OpenSpec — 5 minutiga töövoog
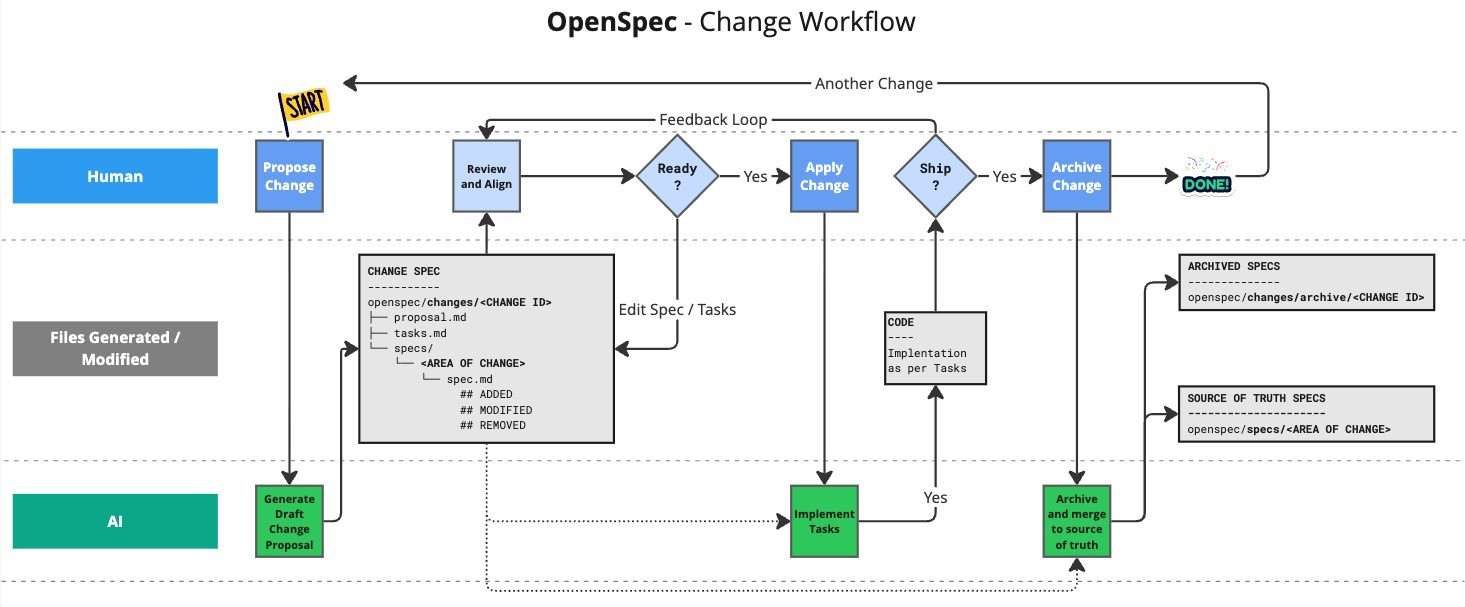
OpenSpec on kolmest peamisest SDD raamistikust kõige lihtsam: kerge, muudatuse-keskne, sobib olemasolevale koodibaasile (brownfield). Setup 5 minutit. Vajab Node.js ≥ 20.19.
Install (IDE suletud):
npm install -g @fission-ai/openspec@latest
cd my-project
openspec init
init küsib, milliseid harness'e kasutad (Pi, Claude Code, Kilo Code, ...) ja tekitab openspec/ kausta. Projekti reeglid (tech stack, koodistiil, gotchas) kirjutad faili openspec/config.yaml.
Neli käsku (slash-käsud sinu harness'is):
| Käsk | Mida teeb | Millal |
|---|---|---|
/opsx:explore | Mõtle ideed läbi enne, kui midagi lood | Kui pole kindel, mida teha |
/opsx:propose <kirjeldus> | Loob muudatuse + kõik planeerimise artefaktid | Vaikimisi algus |
/opsx:apply <change-name> | Implementeerib tasks.md järgi | Kui artefaktid on üle vaadatud |
/opsx:archive <change-name> | Lõpetab muudatuse, liigutab arhiivi | Pärast merge'i |
Neli artefakti igas muudatuses, kaustas openspec/changes/<change-name>/:
| Fail | Sisu | Peamine lugeja |
|---|---|---|
proposal.md | Miks seda muudatust vaja on? Mis muutub? | Stakeholder, PR reviewer |
specs/ | Käitumisleping: Requirements (MUST/SHOULD/MAY) + Scenarios (WHEN/THEN) | Tester, AI, järgmine arendaja |
design.md | Tehnilised otsused + põhjendused + riskid + non-goals | Siin on sinu lisaväärtus |
tasks.md | Checklist implementeerijale | AI |
Näide spec'i requirement'ist:
### Requirement: Auto-assign user role on external registration

The system SHALL automatically assign the "user" role to any new user
account created through Microsoft authentication.

#### Scenario: New user registers via Microsoft auth

- **WHEN** a user authenticates with Microsoft for the first time
  and completes account creation
- **THEN** the system creates a new user account AND assigns the "user"
  role to that account
MUST/SHALL/SHOULD/MAY on RFC 2119 keel — mudel (ja inimene) teab täpselt, mis on kohustuslik vs soovitatav vs valikuline. WHEN/THEN on Gherkin stiil. Üks loogiline muudatus = üks change; "lisa feature X ja refaktori Y" on kaks muudatust.
Süvitsi: Loeng 23 — OpenSpec, OpenSpec Workflows.
Viited ja lingid
Kooli ligipääs
- ai-proxy.cm.itcollege.ee — API-võti, krediit, kasutus
- Loeng 99 — ai-proxy — endpointid, täiskonfid (Pi, opencode, Kilo Code), curl näited
- Pi agent paigaldusjuhend (enos.itcollege.ee)
Tööriistad
- pi.dev · github.com/earendil-works/pi
- OpenSpec · Workflows
- Martin Fowler / Birgitta Böckeler — Spec-driven development tools
Täisloengud selles aines
- 01 Intro · 02 Token · 21 AI tooling · 22 Spec-driven · 23 OpenSpec · 26 Tools · 27 MCP · 30 Agents
- Külalisloengud samast materjalist pikemalt: 93 Senior, 94 BitWeb
Viimati uuendatud: september 2026. Mudelid ja hinnad muutuvad kiiresti — kontrolli ai-proxy lehelt, mis parasjagu saadaval on.